サンプルデータの生成
ビジネスの意思決定や学術研究において、データの分布をすばやく把握できる「箱ひげ図(ボックスプロット)」は不可欠なツールです。しかし、グラフを作成した際に上下にぽつんと現れる独立した点——「外れ値」の存在に頭を悩ませた経験を持つ担当者は少なくありません。
「なぜ境界線は四分位範囲の1.5倍なのか」「この外れ値は機械的に削除してよいのか」という疑問は、実務のデータクレンジング現場でも頻繁に議論が巻き起こるテーマです。統計学的な定義から、計算手順、エクセルやPythonでの実践的な出力方法、現場で避けるべき除外リスクまで、データリテラシーの要点を徹底検証します。
📌 【この記事の重要ポイントまとめ】
- 要点1:外れ値の基準「四分位範囲(IQR)の1.5倍」は、正規分布上で約99.3%をカバーし、誤検出を0.7%前後に抑える実用的なバランスとして提唱された。
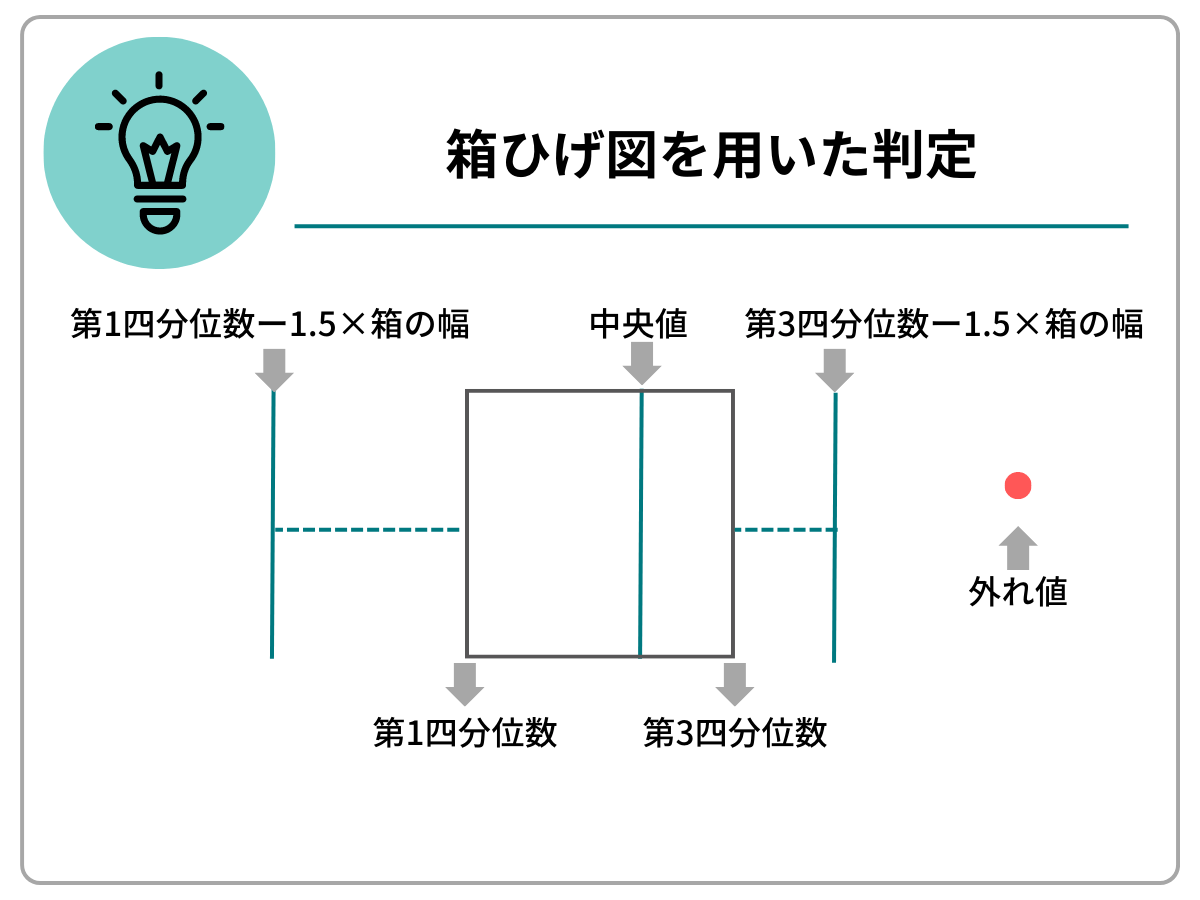
- 要点2:計算は「第1四分位数(Q1)- 1.5×IQR」および「第3四分位数(Q3)+ 1.5×IQR」で行い、範囲外の実データが独立した「点」としてプロットされる。
- 要点3:外れ値を安易に除外することは重大なシグナル(不正検知や優良顧客層)の喪失につながるため、入力ミス等の明確な要因がない限り別枠で分析するのが原則である。
【基礎知識】箱ひげ図の外れ値とは何か?定義と四分位範囲(IQR)の仕組み
統計学における統計 外れ値 定義とは、「測定されたデータ群の中で、他の大多数の観測値から極端に離れた値」を指します。平均値や標準偏差を用いた分析では、たった1つの極端な数値によって全体像が大きく歪んでしまう弱点がありますが、これを補うために重用されるのが順位に基づいた要約統計量です。
箱ひげ図は、データを小さい順に並べ替えたときの位置をもとに、以下の5数要約を可視化します。
まず基礎となるのが四分位数 求め方です。全データを昇順に整列させ、下から25%の位置にある数値を「第1四分位数(Q1)」、50%の中央値を「第2四分位数(Q2)」、75%の位置にある数値を「第3四分位数(Q3)」と呼びます。このQ3からQ1を差し引いた区間を四分位範囲 IQR(Interquartile Range)と呼び、データの中央50%が集まる「ばらつきの幅」を表します。
箱ひげ図において、箱の上下(または左右)に伸びる線の終端を決定するのが箱ひげ図 ひげの長さ 基準です。一般的には、Q1およびQ3から「IQRの1.5倍」伸ばした境界線(フェンス)の内側にある最も極端な実データまでひげを伸ばします。そして、この境界線を越えたデータはひげに含めず、独立した箱ひげ図 外れ値 点としてシンボル表示するルールが定着しています。
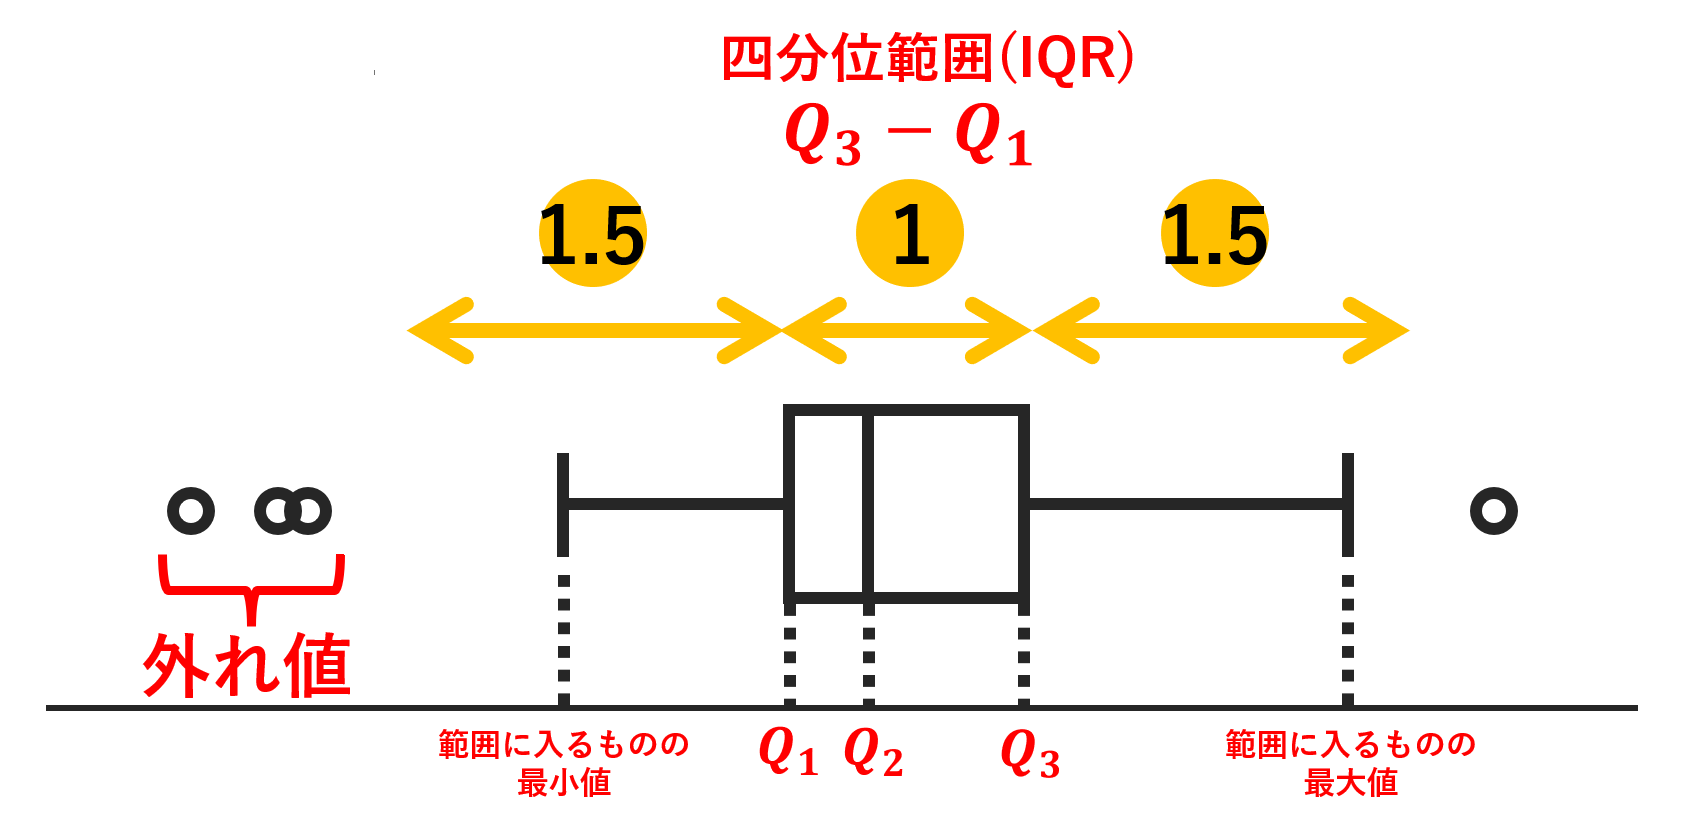
【疑問を解明】外れ値の基準はなぜ「IQRの1.5倍」なのか?考案者チューキーの意図
現場の分析者から最も多く寄せられる疑問が、箱ひげ図 外れ値 1.5倍 理由です。「なぜ2倍や1倍ではなく、1.5という中途半端な係数が採用されているのか」という問いの答えは、探索的データ解析(EDA)の父と呼ばれる米国の統計学者ジョン・チューキー(John W. Tukey)が1977年に提唱した設計思想にあります。
データが正規分布に従うと仮定した場合、数学的に以下の関係が成り立ちます。
正規分布において、第1四分位数と第3四分位数は平均値 $\mu$ を中心に $\pm 0.6745\sigma$($\sigma$ は標準偏差)の位置に存在します。したがって、四分位範囲は $\text{IQR} \approx 1.349\sigma$ となります。ここで外れ値判定の境界線を「$Q3 + 1.5 \times \text{IQR}$」と計算すると、平均値からの距離は以下のようになります。
$0.6745\sigma + (1.5 \times 1.349\sigma) \approx 2.698\sigma$
つまり、$\pm 1.5 \times \text{IQR}$ という基準は、正規分布における「$\pm 2.7\sigma$(標準偏差の約2.7倍)」にほぼ匹敵する領域を指し示します。正規分布において $\pm 2.7\sigma$ の内側にデータが収まる確率は約99.3%であり、外側に外れる確率はわずか約0.7%(片側約0.35%)です。
チューキーは、係数を「1.0倍」(約 $\pm 2.0\sigma$、約5%が誤検知される)にすると正常なばらつきまで過剰に外れ値として拾いすぎてしまい、逆に「2.0倍以上」にすると異常値を見逃すリスクが高まると判断しました。手計算でも暗算しやすく、かつ「正常値の99%以上を保護しながら、異常の兆候をスクリーニングする絶妙な妥協点」として導き出されたのが「1.5」という数値でした。
なお、チューキーは $1.5 \times \text{IQR}$ を超える値を「外れ値(Outliers / Outside values)」とし、$3.0 \times \text{IQR}$ を超える極端な値を「極端な外れ値(Far out values)」と分類して区別することを推奨しています。
【実践ガイド】箱ひげ図の外れ値の計算手順とExcel・Pythonでの出力法
実務で外れ値を特定するための箱ひげ図 外れ値 計算は、3つのステップで完了します。
例として、11個のサンプルデータ「10, 19, 20, 22, 24, 25, 27, 28, 30, 31, 55」を扱います。
- 四分位数を算出:最小値=10、Q1=20、中央値(Q2)=25、Q3=30、最大値=55
- 四分位範囲(IQR)を計算:$\text{IQR} = Q3 - Q1 = 30 - 20 = 10$
- 境界値(上下のフェンス)を算出:
- 下限境界:$Q1 - (1.5 \times \text{IQR}) = 20 - 15 = 5$
- 上限境界:$Q3 + (1.5 \times \text{IQR}) = 30 + 15 = 45$
この場合、最小値「10」は下限(5)以上であるため正常範囲内ですが、最大値「55」は上限(45)を上回るため外れ値と判定され、ひげの上端は上限を超えない最大の実データ「31」までとなり、「55」は独立した点として描画されます。
Excel(エクセル)での作成と外れ値表示の設定
表計算ソフトを用いた箱ひげ図 外れ値 エクセルでの描画手順は、バージョン2016以降で大幅に簡略化されました。
対象データ範囲を選択し、上部メニューの「挿入」タブから「統計グラフの挿入」→「箱ひげ図」を選択するだけで自動生成されます。外れ値の設定を確認・変更したい場合は、グラフ上の系列(箱の部分)を右クリックして「データ系列の書式設定」を開き、系列のオプション内にある「外れ値のポイントを表示する」のチェックボックスを操作します。
なお、数式で個別に判定フラグを立てたい場合は、QUARTILE.INC または QUARTILE.EXC 関数を組み合わせてIQRを算出し、IF文で境界値を超えているかを判定するのが実務上の定石です。
Python(Matplotlib / Seaborn)での実装コード
データサイエンス現場における箱ひげ図 外れ値 Pythonの実装では、SeabornやMatplotlibライブラリが標準的に利用されます。
import matplotlib.pyplot as plt import seaborn as sns import numpy as np data = [10, 19, 20, 22, 24, 25, 27, 28, 30, 31, 55] # Seabornによる箱ひげ図の描画(デフォルトでwhis=1.5が適用される) plt.figure(figsize=(6, 4)) sns.boxplot(y=data, color="skyblue") plt.title("Boxplot Outlier Detection (IQR x 1.5)") plt.ylabel("Values") plt.show() Matplotlibの boxplot() 関数やSeabornの boxplot() では、引数 whis=1.5 が標準設定となっており、この係数を whis=3.0 に変更することで極端な外れ値のみを抽出するカスタマイズも容易に行えます。
【データ比較】外れ値の検出手法を徹底比較|箱ひげ図と他統計モデルの違い
データ特性やサンプルサイズに応じて、適切な外れ値検出手法は異なります。箱ひげ図のIQR法と、実務で併用される代表的手法の特徴を整理しました。
| 手法名 | 判定基準・計算ロジック | 前提条件・適用範囲 | 編集部の見解・評価 |
|---|---|---|---|
| 箱ひげ図(IQR法) | Q1 - 1.5×IQR 未満 Q3 + 1.5×IQR 超過 | ノンパラメトリック (分布の形状を問わない) | 探索的データ分析の第一歩に最適。歪んだ分布でも頑健に機能する。 |
| 3シグマ法($3\sigma$則) | 平均値 $\pm 3\times$ 標準偏差 の範囲外 | 正規分布が前提 (データ数1,000件以上推奨) | 製造ラインの品質管理で標準的。外れ値自身が平均と分散を歪める点に注意。 |
| スミルノフ・グラブス検定 | 検定統計量 $T$ を算出し、有意水準(5%等)で検定 | 正規分布が前提 (1つずつ繰り返し検定) | 統計的仮説検定に基づく厳密な判定が可能。製薬・化学実験の品質保証向け。 |
| アイソレーションフォレスト | 決定木のランダム分割による隔離の深さ(Anomaly Score) | 機械学習モデル (多次元・多変量データ対応) | 金融取引の不正検知やサイバー攻撃検出など、高次元データ解析で必須。 |
【実態検証】外れ値は即削除すべきか?現場で起きるデータ欠損トラブルと正しい扱い
データ前処理の現場で最も危険な誤謬は、「箱ひげ図で点として表示されたから削除する」という短絡的な処理です。実務における箱ひげ図 外れ値 扱いは、その発生原因を切り分けることから始まります。
外れ値が発生する要因は、大きく分けて以下の3種類が存在します。
- 1. 入力ミス・測定エラー:「年齢欄に1200歳と入力された」「センサー故障でマイナス値が記録された」などの明らかな不具合。
- 2. サンプリングの不一致:「一般世帯の年収調査に大企業の創業者が1名紛れ込んだ」など、母集団の定義から外れたデータ。
- 3. 自然な極値(本質的な変動):「年間購買額が突出して高いロイヤルカスタマー」「数年に一度の大規模障害ログ」。
明確な箱ひげ図 外れ値 除外 理由として正当化されるのは「1」および「2」のケースに限られます。測定器のバグやタイポ(入力誤り)であることが客観的に証明できる場合のみ、レコードを削除(欠損値処理)するか、ログを突き合わせて正しい値に修正します。
一方、「3」のケースを削除してしまうと、モデルの予測精度を大きく損なう原因になります。例えば、ECサイトの売上分析で富裕層のまとめ買いデータを外れ値としてカットすれば、高価格帯商品のプロモーション戦略を見誤ることになります。不正送金検知システムでは、外れ値こそが検出すべき「主役」です。
自然な極値に対しては、データを削除するのではなく「対数変換を行って分布の歪みを整える」「トリミング(クリッピング)処理を施す」「中央値やロバスト回帰など外れ値の影響を受けにくいアルゴリズムを採用する」といった適切なアプローチを選択しなければなりません。

【一般に知られていない盲点】ネットの誤解とスミルノフ・グラブス検定との境界線
Web上の解説記事やコミュニティフォーラムにおいて、箱ひげ図と仮説検定の混同が散見されます。特に多い誤解が、スミルノフ・グラブス検定との使い分けです。
「箱ひげ図で外れ値が出たから、このデータは統計学的に異常値であると証明された」と解釈するのは明らかな誤りです。箱ひげ図の1.5倍ルールは、あくまで探索的データ解析のためのヒューリスティックな「スクリーニング基準」に過ぎず、確率的な有意性を検定したものではありません。
一方、スミルノフ・グラブス検定は「データが正規分布に従っている」という厳格な前提のもとで、最大値または最小値が確率的に棄却域(例えば有意水準5%)に入るかを判定する検定手法です。1回の検定で判定できる外れ値は1つだけであり、外れ値を除外しては再計算を繰り返すステップを踏む必要があります。
また、所得分布やWebサイトの滞在時間のように、裾野が右に長く伸びる「対数正規分布」や「べき乗則」に従うデータに対して箱ひげ図をそのまま適用すると、正常な上位データが大量に外れ値として判定されてしまいます。データの分布形状を確認せずに1.5倍ルールを盲信することは、分析の根幹を揺るがす重大な落とし穴となります。
【プロの結論】データ分析で失敗しないための外れ値ハンドリング判断基準
データドリブンな意思決定を行う上で、外れ値に直面した際の行動指針を明確に定めておくことがプロジェクトの成否を分けます。
機械的な除外処理を適用してよいケース
- 製造現場のIoTセンサーにおいて、物理的にあり得ない数値(温度計が絶対零度を下回るなど)が記録されている場合
- アンケート調査で明らかな連番入力や、文字コード化けによる異常値が混入している場合
- 線形回帰分析において、少数の入力ミスデータが回帰直線の傾きを過剰に牽引していることが確認された場合
外れ値を保持・別枠分析すべき慎重なケース
- 金融取引の不正リスク管理、セキュリティログの侵入検知、サーバー負荷のスパイク監視
- LTV(顧客生涯価値)やVIP顧客の購買行動など、ビジネス上の高付加価値領域を分析する場合
- 創薬実験や臨床試験など、予期せぬ副作用や特異な生体反応のシグナルを見逃してはならない場合
データの外側に現れる「点」は、単なるノイズではなく、ビジネスにおける最大のビジネスチャンスや破滅的なリスクの予兆を含んでいるケースが多々あります。1.5倍ルールの計算式を正しく理解した上で、その数値が生まれた文脈を深く掘り下げる姿勢こそが、真のデータ活用につながります。
【箱ひげ図の外れ値】に関するよくある質問(FAQ)
Q1:箱ひげ図を作成すると外れ値の点が大量に表示されてしまいます。どうすればよいですか?
A1:データが正規分布ではなく、右側に長い裾を持つ歪んだ分布(年収、アクセス数、売上金額など)になっている可能性が高いです。無理に外れ値を削除するのではなく、データを「対数変換(Log変換)」してから箱ひげ図を再作成するか、上位数%をパーセンタイル値で集計する手法へ切り替えることを検討してください。
Q2:1.5倍ではなく「3倍」を基準にするケースはありますか?
A2:存在します。統計学者ジョン・チューキーは、$1.5 \times \text{IQR}$ を「軽度の外れ値(Outliers)」、$3.0 \times \text{IQR}$ を「重度の外れ値(Far out values / 極端値)」と定義しました。誤検知を極力減らし、極端に異常なデータのみを自動アラートの対象にしたいシステム運用などでは、3.0倍の基準が実務的に広く採用されています。
Q3:Excelの箱ひげ図で外れ値の「点」が表示されません。何が原因ですか?
A3:主な原因は2つあります。1つ目は、選択したデータセット内に実際に $1.5 \times \text{IQR}$ を超える数値が存在しない場合(この場合ひげの先端が最大値・最小値になります)。2つ目は、グラフの「データ系列の書式設定」で「外れ値のポイントを表示する」のチェックが外れている場合です。書式設定メニューから該当オプションが有効になっているか確認してください。
Q4:箱ひげ図の外れ値判定とスミルノフ・グラブス検定はどちらを使うべきですか?
A4:データの探索段階や分布の確認には、前提条件が不要な箱ひげ図(IQR法)を使用するのが適しています。一方、品質管理や公的機関への提出データなど、正規分布が確認された母集団に対して「5%水準で統計的に異常値である」と厳密に証明・報告したい場合にはスミルノフ・グラブス検定を選択します。
まとめ:箱ひげ図の外れ値を正しく読み解きデータリテラシーを高める
箱ひげ図の外れ値を規定する「四分位範囲の1.5倍」という基準は、正規分布の約99.3%をカバーする数学的背景と、手計算時代の合理性を兼ね備えた洗練されたルールです。
しかし、グラフ上に現れる点は単なる「排除すべきゴミ」ではありません。計算ロジックを把握した上で、それがエラーなのか、貴重なビジネスシグナルなのかを見極める洞察力を持つことが、現代のデータ活用における最も重要なリテラシーといえます。 (出典: 箱 ひげ 図 外れ 値(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。